2024年6月15日 星期六

Spring Cache + AspectJ 背後的大致流程

因為最近在專案中整合 Spring Cache,不過原生的 Spring Cache 支援的功能有點基本,我們想要擴充它的功能,所以需要稍微了解一下 Spring Cache 背後到底怎麼運作的,我們才有辦法找出比較合適的擴充方式。

網路上可以找到一些中國網友的原始碼解析,不過大多數找到的都是用預設的 Spring AOP,但我們專案的狀況會使用 AspectJ,所以這邊會紀錄 AspectJ 的狀況是如何運作的。

另外,因為我們還在用 Spring Boot 2.7,所以這裡會先關注在 Spring v5.3.31 版的原始碼。相關的 Spring Cache 官方文件可以參考這裡

Spring Cache 的使用方式

那麼要從哪裡開始追蹤呢?先來看一下 Spring Cache 怎麼使用的。

@Configuration
@EnableCaching
public class AppConfig {
}

@Cacheable("books")
public Book findBook(ISBN isbn) {...}

Spring Cache 最基本的使用方式,就是像上面的例子那樣,用 @Cacheable 註解來告訴 Spring 說 findBook(...) 這個 method 要被 cache,並且需要提供一個 configuration,上面有 @EnableCaching 來要求要啟用 cache。這裡其實還需要一點其他的設定,不過因為不是這裡的重點,所以我都先略過 😆。總之,起點就是 @EnableCaching 了。

Cache 的載入流程

載入 Configuration

首先從 @EnableCaching 這個註解開始看,它的內容大概是這樣:

@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
@Documented
@Import(CachingConfigurationSelector.class)
public @interface EnableCaching {
}

可以注意到,它宣告了 @Import,因此 Spring 會使用它指定的 CachingConfigurationSelector 來得知到載入什麼東西。

CachingConfigurationSelector (git) 是一個透過 parent 實作了 ImportSelector 的類別,因此它主要提供 selectImports 這個方法,用來告訴 Spring 說要載入的 class 的 FQDN 是什麼。比較重要的內容如下:

public class CachingConfigurationSelector extends AdviceModeImportSelector<EnableCaching> {
  ...
  private static final String CACHE_ASPECT_CONFIGURATION_CLASS_NAME =
            "org.springframework.cache.aspectj.AspectJCachingConfiguration";
  ...

  @Override
  public String[] selectImports(AdviceMode adviceMode) {
    switch (adviceMode) {
      case PROXY:
        return getProxyImports();
      case ASPECTJ:
        return getAspectJImports();
      default:
        return null;
    }
  }

  ...
  private String[] getAspectJImports() {
    List<String> result = new ArrayList<>(2);
    result.add(CACHE_ASPECT_CONFIGURATION_CLASS_NAME);
    if (jsr107Present && jcacheImplPresent) {
      result.add(JCACHE_ASPECT_CONFIGURATION_CLASS_NAME);
    }
    return StringUtils.toStringArray(result);
    }

selectImports() 中,會依據註解設定的 adviceMode 決定 import 時要給哪個 class name,因為前面提到我們要用的是 AspectJ,並且我們並沒有要用 JSR-107,所以這裡就只看純 AspectJ 的狀況。所以可以看出,這裡如果 adviseMode 設定為 AspectJ 的話,它會回覆的 FQDN 是 org.springframework.cache.aspectj.AspectJCachingConfiguration

於是接著來看一下 AspectJ 的 Configuration (git) 寫了什麼~。

@Configuration(proxyBeanMethods = false)
@Role(BeanDefinition.ROLE_INFRASTRUCTURE)
public class AspectJCachingConfiguration extends AbstractCachingConfiguration {

  @Bean(name = CacheManagementConfigUtils.CACHE_ASPECT_BEAN_NAME)
  @Role(BeanDefinition.ROLE_INFRASTRUCTURE)
  public AnnotationCacheAspect cacheAspect() {
    AnnotationCacheAspect cacheAspect = AnnotationCacheAspect.aspectOf();
    cacheAspect.configure(this.errorHandler, this.keyGenerator, this.cacheResolver, this.cacheManager);
    return cacheAspect;
  }

}

這裡最主要就是提供一個 Bean,這個 Bean 是用來建立 AnnotationCacheAspect 的,並且在建立的同時會把註解上的設定、以及其他需要建立的例如 ErrorHandlerKeyGeneratorCacheResolverCacheManager 等東西都一起注入進去。

所以到這裡稍微總結一下,這整段代表的意思,是當 Spring 讀到 @EnableCaching 註解時,會基於這個 Selector 決定去載入指定的 Configuration,然後就會依據 Configuration 的內容去建立包含 CacheManager 等等的 Bean,並且初始化一個 Aspect,把那些 Aspect 需要用到的 Bean 注入到 Aspect 當中。

Aspect 被初始化以後,後面的主要工作應該就是 AspectJ 的範疇了。不過因為我目前還沒有很完整地看過 AspectJ 的文件,所以只有大略知道一些資訊,如果紀錄有誤歡迎提醒 😆。

AspectJ 在縫合的時候,會讓 Aspect 擁有 aspectOf() 的 method (doc),所以 Spring 才有辦法呼叫 aspectOf() 來取得這個 Aspect,並且對它做設定。

載入並註冊 Aspect

前段被建立的 AnnotationCacheAspect (git) 是一個 .aj 檔,所以內容基本上就是 AspectJ 的定義了:

public aspect AnnotationCacheAspect extends AbstractCacheAspect {

  public AnnotationCacheAspect() {
    super(new AnnotationCacheOperationSource(false));
  }

  /**
   * Matches the execution of any public method in a type with the @{@link Cacheable}
   * annotation, or any subtype of a type with the {@code @Cacheable} annotation.
   */
  private pointcut executionOfAnyPublicMethodInAtCacheableType() :
      execution(public * ((@Cacheable *)+).*(..)) && within(@Cacheable *);

  ...

  /**
   * Definition of pointcut from super aspect - matched join points will have Spring
   * cache management applied.
   */
  protected pointcut cacheMethodExecution(Object cachedObject) :
    (executionOfAnyPublicMethodInAtCacheableType()
        || executionOfAnyPublicMethodInAtCacheEvictType()
        || executionOfAnyPublicMethodInAtCachePutType()
        || executionOfAnyPublicMethodInAtCachingType()
        || executionOfCacheableMethod()
        || executionOfCacheEvictMethod()
        || executionOfCachePutMethod()
        || executionOfCachingMethod())
      && this(cachedObject);

這裡我把其他部份都略過了,只先看它定義關於 @Cacheable 的部份。它定義了一個 pointcut 叫做 executionOfAnyPublicMethodInAtCacheableType(),會被橫切到所有有標註 @Cacheable 的 public method 上。那麼 pointcut 要執行的邏輯是什麼呢?這就需要看它的 parent AbstractCacheAspect (git) 了。

public abstract aspect AbstractCacheAspect extends CacheAspectSupport implements DisposableBean {
  ...
  @SuppressAjWarnings("adviceDidNotMatch")
  Object around(final Object cachedObject) : cacheMethodExecution(cachedObject) {
    MethodSignature methodSignature = (MethodSignature) thisJoinPoint.getSignature();
    Method method = methodSignature.getMethod();

    CacheOperationInvoker aspectJInvoker = new CacheOperationInvoker() {
        public Object invoke() {
          try {
            return proceed(cachedObject);
          }
          catch (Throwable ex) {
            throw new ThrowableWrapper(ex);
          }
        }
    };

    try {
      return execute(aspectJInvoker, thisJoinPoint.getTarget(), method, thisJoinPoint.getArgs());
    }
    catch (CacheOperationInvoker.ThrowableWrapper th) {
      AnyThrow.throwUnchecked(th.getOriginal());
      return null; // never reached
    }
  }
}

可以看出,它定義了一個 around 並綁定在 cacheMethodExecution() 上,而 cacheMethodExecution() 這個 pointcut 則是定義一系列的 pointcuts。所以我的理解是,它應該是把 around 綁到所有它列出來的 pointcut,也就是像是 @Cacheable`CachePut 等等的 pointcut。

接著來看這個 around 裡面的內容。它首先先建立了一個 CacheOperationInvoker 的 instance,這個 invoker 的目的是用來呼叫被 cache 的 method 的,接著就去呼叫 execute(),把 JoinPoint 的資訊以及剛剛建立的 invoker 都傳進去。

execute()AbstractCacheAspect 從它的 parent CacheAspectSupport 繼承來的,所以接著就再去看 CacheAspectSupport 裡的內容。不過裡面內容蠻多的,所以只先節錄了 execute() 的部份:

@Nullable
protected Object execute(CacheOperationInvoker invoker, Object target, Method method, Object[] args) {
  // Check whether aspect is enabled (to cope with cases where the AJ is pulled in automatically)
  if (this.initialized) {
    Class<?> targetClass = getTargetClass(target);
    CacheOperationSource cacheOperationSource = getCacheOperationSource();
    if (cacheOperationSource != null) {
      Collection<CacheOperation> operations = cacheOperationSource.getCacheOperations(method, targetClass);
      if (!CollectionUtils.isEmpty(operations)) {
        return execute(invoker, method,
            new CacheOperationContexts(operations, method, args, target, targetClass));
      }
    }
  }

  return invoker.invoke();
}

這段最主要的行為,是在檢查自己初始化的狀態,如果初始化還沒完成,就直接呼叫 invoker,否則就把 cache 的服務 (即 CacheOperationSource) 準備好,然後再去呼叫第二個 execute()

第二個 execute() (git) 內容更長,所以這裡也是先篩掉一些內容,只先看最單純的部份:

private Object execute(final CacheOperationInvoker invoker, Method method, CacheOperationContexts contexts) {
  // Special handling of synchronized invocation
  if (contexts.isSynchronized()) {
    ...
  }

  ...

  // Check if we have a cached value matching the conditions
  Cache.ValueWrapper cacheHit = findCachedItem(contexts.get(CacheableOperation.class));

  ...

  Object cacheValue;
  Object returnValue;

  if (cacheHit != null && !hasCachePut(contexts)) {
    // If there are no put requests, just use the cache hit
    cacheValue = cacheHit.get();
    returnValue = wrapCacheValue(method, cacheValue);
  }
  else {
    // Invoke the method if we don't have a cache hit
    returnValue = invokeOperation(invoker);
    cacheValue = unwrapReturnValue(returnValue);
  }

  ...

  // Process any collected put requests, either from @CachePut or a @Cacheable miss
  for (CachePutRequest cachePutRequest : cachePutRequests) {
    cachePutRequest.apply(cacheValue);
  }

  ...

  return returnValue;
}

節錄下來的部份就是 Spring Cache 實際上操作 cache 服務和被 cache 的 method 的行為了。首先它透過 findCachedItem() 取得 cache 的結果,如果 cache hit 了,就把它放進 returnValue 中;反之,如果 cache miss 了,則會去執行被 cache 的 method 取得最新的執行結果,然後放進 returnValue 裡。

中間有一部分收集 put requests 的程式碼被我過濾掉了沒貼進來,不過大致上就是最後它會依據收集到要做的 put requests 開始一個一個 apply 到 cache 中,完成 cache 的更新。


2024年5月5日 星期日

Matryoshka Representation Learning (MRL) 與 Vespa

這幾天經由 Vespa 的文章,讀到 OpenAI 在今年(2024 年)二月份的一篇在解說 MRL (Matryoshka Representation Learning) 的文章,看起來真的相當有趣!不過我並不是這個領域的專業,所以細部的內容我也沒有完全理解,這篇筆記大體只是我自己在應用上的基本理解。如果內容有誤也歡迎留言提醒。😇

MRL 是什麼?

Matryoshka doll 就是俄羅斯娃娃,而 Matryoshka Representation Learning 就是一種利用類似俄羅斯娃娃的特性(小的娃娃可以被裝進大的娃娃裡)做出來的 Embedding 方法,或者說是東西的表達手法。

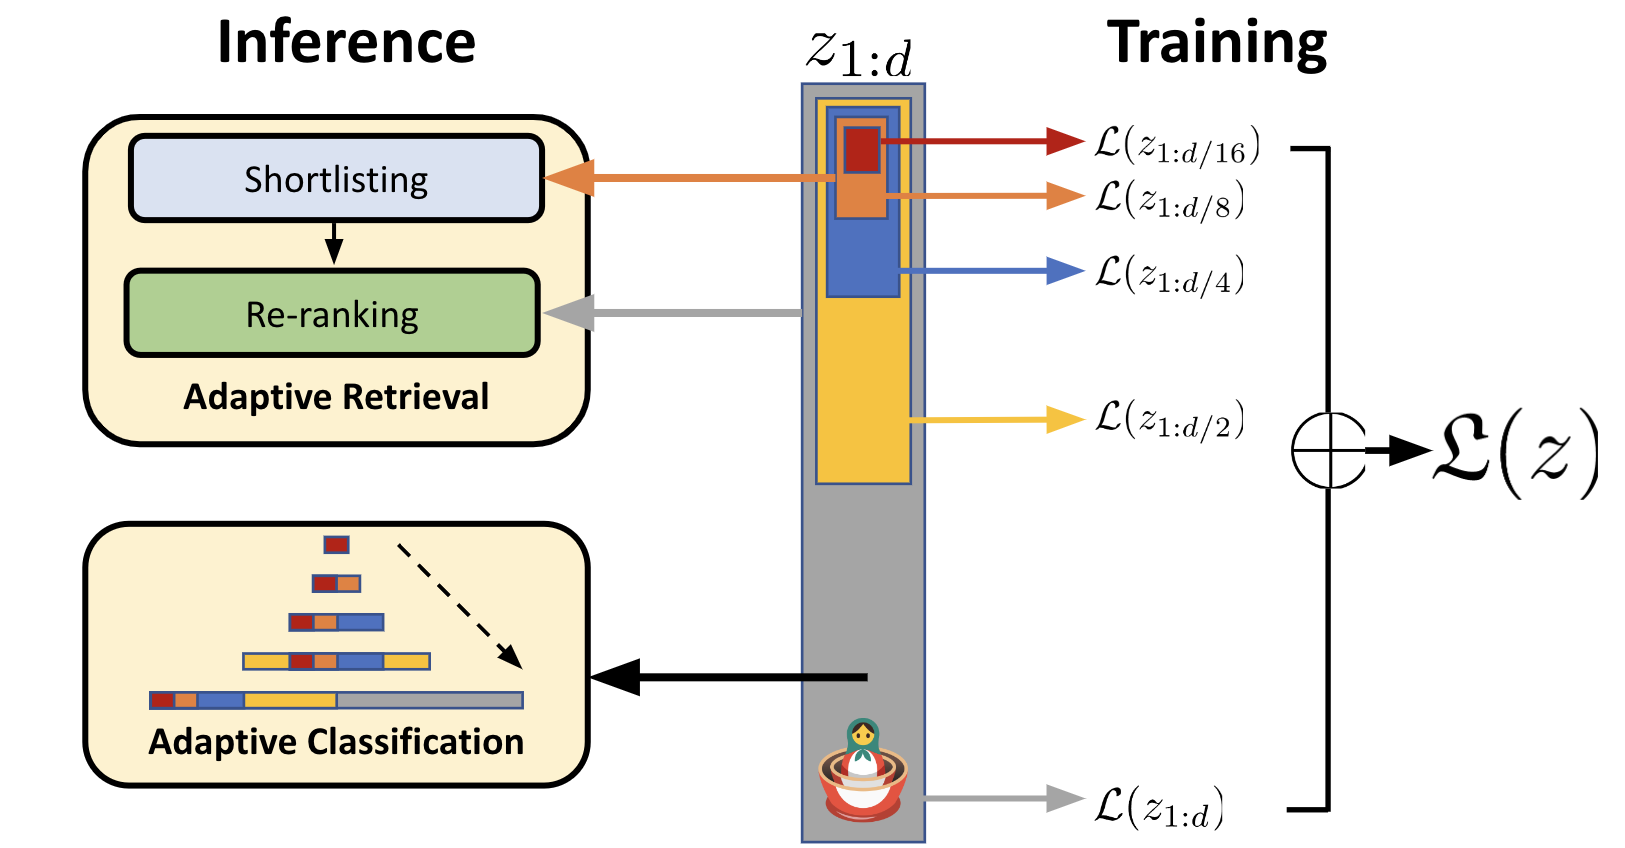
那麼 MRL 跟其他 Embedding 方法最大的差異是什麼呢?就我目前的理解,最大的差異就是上述提到的,它具有俄羅斯娃娃的特性。具體來說,就是小的 Embedding 可以被放在大的 Embedding 裡,或者說是大的 Embedding 切割掉尾巴後,就幾乎等於是小的 Embedding。這個特性最主要的優勢,是在於我們可以不用針對不同維度的 Embedding 分別儲存不同的 Embedding,而是可以統一存一個 Embedding,在需要高維的時候使用 Embedding 裡的比較多內容、需要低維(更快更低成本)的時候則使用 Embedding 裡的一部份內容即可。

俄羅斯娃娃

Vespa 與 MRL

那麼回到 Vespa 的使用情境,MRL 可以帶來什麼效果呢?首先如同 MRL 文章在上圖中提到的,MRL 會很適合用在 multi-phase ranking 的場合,例如先使用低維度來找出較符合結果的 candidates,然後第二階段時再針對這些 candidates 使用高維度來做更精準的計算,找出最佳的結果。

Vespa 二月份的文章中,首先提到他們做了一點基本的實驗,發現 MRL 產生的 Embedding 在使用相同模型的情況下,產生 8-dimension 跟 3072-dimension 的 Embedding,確實中間只差了 scale 而已,本質上非常相似。接著他們實際實驗了把 3072-dimension 的 Embedding,裁掉尾巴並只留下最前面的 8-dimension,然後去跟一開始就用 8-dimension 產生的 Embedding 做 cosine similarity 比較,發現兩者的相似度高達 99.99999999999996%

最後,Vespa 團隊用 COVID-19 的資料集做了實際的搜尋實驗,分別有以下幾種:

  • query_exact - 使用完整的 3072-dimension 並且不使用 ANN,也就是做最精準的語義搜尋。
  • query_256 - 改為使用 256-dimension 的低維度 Embedding,同樣也不使用 ANN。
  • query_256_ann - 使用 256-dimension 的低維度 Embedding,同時使用 ANN 做語義搜尋。
  • query_rerank - 使用 256-dimension 的 Embedding 作為 1st-phase,選出 top 100,然後用 3072-dimension 作為 2nd-phase
    結果如下:
run query_exact
.................................................. avg query time 2.7918 s
run query_256
.................................................. avg query time 0.3040 s
run query_256_ann
.................................................. avg query time 0.0252 s
run query_rerank
.................................................. avg query time 0.0310 s

query_exact     ndcg_cut_10: 0.7870
query_256     ndcg_cut_10: 0.7574
query_256_ann     ndcg_cut_10: 0.7552
query_rerank     ndcg_cut_10: 0.7886

先看效能的部份,從 3072-dimensions 改為使用 256-dimensions 可以大幅加快搜尋速度,query time 只有原本的大約 11% 而已。而使用 ANN 的話,跟最開始的 query_exact 比較,甚至是只用了不到 1% 的時間!但效能提昇了,搜尋結果變差了多少呢?從 NDCG 來看,差異從 0.787 下降到 0.755 ,其實差異並沒有非常顯著。

如果我們直接比較 query_exactquery_rerank 的話,得到的結果是 query time 是原本的 1.1% ,而 NDCG 幾乎一樣!從數據來看,MRL 的潛力真的相當大 😍

2024年3月18日 星期一

Stable Diffusion 加速

簡要紀錄一下目前測試過的 Stable Diffusion 加速方法。之後如果有再看到其他通用的作法,也會視情況再紀錄過來這篇文章。

  • xformer
  • cuDNN

目前這裡紀錄的時間,會用以下的環境設定來測試時間。至於為什麼用這個呢?其實沒什麼原因,就隨便找一個 XD。

  • Windows 11
  • Stable Diffusion webui 1.8.0
  • checkpoint 模型:Mistoon_Anime v3.0
  • 正向提示詞:
    masterpiece,best quality,1girl,solo,girls und panzer,messy hair,smallbreasts,brown hair,long hair,orange eyes,side pony tail,beach,swimsuit,swim suit,smug,full body,
    
  • 反向提示詞:
    EasyNegative,(worst quality:1.4),(low quality:1.4),
    
  • batch size:4

啟用 xformer

這個選項目前還不太清楚傷害是什麼,似乎基本是無害的,不過有看到像是 openpose 會建議記憶體較低的話可以開,有可能實際上是對成品有點傷害。但對 Stable Diffusion 生圖的效能影響很大,所以如果手上的顯卡不是那麼強大的話,推薦可以考慮。具體來說,我自己的簡單測試結果是啟用後,生圖的時間大約減少了 48%33.2s -> 17.3s),也就是減少將近一半!

啟用方法在現在很簡單,因為 xformer 已經變成 Stable Diffusion webui 的內建套件了,只是預設沒有啟用而已,所以只需要在 webui-user.bat 裡的 call webui.bat 後面加上 --xformers 就可以了。詳細的說明可以參考 Stable Diffusion webui 的 wiki 中關於 xformer 的說明。

call webui.bat --xformers

安裝 cuDNN

這個部份可以參考 reddit 的討論,不過我自己實際測試的結果,cuDNN 有沒有裝好像沒有差別,cuDNN 單獨測試、跟同時啟用 xformer 都有測過,但結果都沒有顯著差異。測試出來的數據如下:

features time
vanilla 33.2s
cudnn 33.2s
xformer 17.3s
cudnn + xformer 17.6s

不過實際上這好像是要去更新 Stable Diffusion 裡的 PyTorch 使用到的 cuDNN 函式庫,因為裡面本來就已經有那 7 個 DLL 檔案了,安裝過程是要把下載下來的 cuDNN 裡的 DLL 覆蓋進去 PyTorch 的資料夾。所以也有可能純粹是因為我用 Stable Diffusion 1.8.0,裡面的 PyTorch 已經更新了它的 cuDNN,所以我測起來才測不出差別。

安裝方法的部份,由於這裡安裝的目的是要給 Stable Diffusion 使用,所以 nVidia 現在有提供的 Windows installer 好像是沒什麼用,因為它會把那些 DLL 裝進 Program Files 裡 XD。還有一點是 webui 1.8.0 的 PyTorch 使用的 cuDNN 似乎是 8.x 版,所以要注意不要下載到最新的 9.0 版,所以推薦是直接去官方的 archive 頁面下載,在我下載的這個時候,8.x 版中的最新版是 8.9.7.29。如果下載錯的話,要把檔案複製到 PyTorch 裡的時候,會發現所有檔案都是新增進去,沒有覆蓋到任何一個檔案,這樣它就不會真的被使用到。下載完以後,把資料夾裡 \bin 裡的總共 7 個 DLL 檔案全部複製到 Stable Diffusion webui 裡的 \venv\Lib\site-packages\torch\lib 並取代裡面同樣檔名的檔案即可。

2024年3月7日 星期四

Stable Diffusion 基本環境安裝

講到繪圖 AI,在初期最有名的應該就是 Midjourney (MJ) 和 Stable Diffusion (SD) 了。後來雖然有不少其他名字陸續冒出來,不過最開始的這兩個,還是依然維持著它們的名氣。因為 side project 的關係,想要試試看繪圖 AI,所以就簡單研究了一下這兩個,發現 Stable Diffusion 可以在自己電腦上面跑,不用買訂閱制的服務!所以就決定嘗試它了!

說是這麼說,但簡單嘗試後發現一個很大的問題,Stable Diffusion 對非 nVidia 顯示卡的使用者相當不友善 😓。雖然不是完全不能用,但就圖片產生速度非常慢,而且環境準備也很麻煩。因為我的顯示卡是 AMD 的大概七年前的中階顯卡,搜尋了一下發現要用 AMD 算圖的環境設定超麻煩,所以立刻就放棄了 😆。試完了一下用 CPU 算圖,不過使用經驗是很多 model 都會有問題,而能用的又很慢,跑一張圖要跑 10 幾分鐘,所以試玩一下後就決定還是要去買新的顯示卡了。於是這篇就會簡單紀錄一下在 Windows 10 的 nVidia 顯卡以及 Stable Diffusion 的基本準備。

準備 NVIDIA 環境

NVIDIA 環境具體來說,就是顯示卡的驅動程式跟 CUDA 相關的東西。這個步驟不算太難,主要要安裝的是以下幾個東西:

  • NVIDIA Geforece Experience(2025 更新:後來改名叫 Nvidia App)
  • CUDA Toolkit
  • NVIDIA cuDNN

其中 Geforece Experience 其實本來不是必要的,不過因為顯示卡驅動程式好像都跟在這裡面,所以多半會一起裝進去。至於 cuDNN 真的就是非必要的,我自己的實際實驗是沒裝它也可以正常使用 Stable Diffusion,不過看官方的說明,感覺這個應該是對計算會有加速的效果之類的,所以還是裝一裝會比較好(但我現在還沒裝 😆)。

CUDA Toolkit 跟 cuDNN 安裝的版本都應該要參考自己的顯示卡和驅動程式對應的版本,可以分別參考官方網站的 CUDA GPUCUDA Driver。舉例來說,在 CUDA Driver 頁面中有寫到 nVidia 驅動程式對應的 CUDA Driver 版本,所以要去看自己的驅動程式應該對應哪一個版本的 CUDA Driver。我的顯示卡有支援最新版,而在寫這篇文章的時候,CUDA Toolkit 最新版是 12.3 (最新版的下載位置) ,不過有個超級重要的經驗是,不要安裝 12.3 版 😆。我試過各種方法都沒辦法成功把 12.3 裝進去,安裝程式會一直顯示安裝失敗,但又不明確提示為什麼失敗。查了 NVIDIA 官方論壇以及 Reddit 的文章後,最後發現改安裝 12.2 (下載位置) 就可以順利安裝完成。

至於 cuDNN,因為我自己沒裝,所以如果之後有裝了再回來補充,可以先參考官方網站的說明

準備 Stable Diffusion 環境

Stable Diffusion 環境有超多文章和影片在教了,例如這篇,這裡就簡單紀錄了 😆。也可以參考這個影片

  1. 安裝 Windows Store 的 Python 3.7。
  2. 下載 Stable Diffusion webui
  3. 在 webui-user.bat 裡面設定 Python 位置。
  4. 執行 webui-user.bat,它會在 venv 資料夾裡建出環境。因為要下載不少東西,會需要一段時間。

到這裡其實 Stable Diffusion 就弄好了。不過聽說 Stable Diffusion 還有必裝外掛,裝了以後它才有實用價值。所以下面還會再紀錄一些外掛的基本資訊。

Stable Diffusion 外掛

外掛們據說是 Stable Diffusion 非常重要的東西,有些外掛沒裝,會讓 Stable Diffusion 很難控制,所以會有常見的一些必裝外掛。這裡逐步紀錄一些我自己找到的資訊,不過使用細節等到我有更多經驗後,再看要不要寫點文章紀錄吧~。

  • 翻譯
  • 提示詞
    • sd-webui-prompt-all-in-one - 可以直接從 webui 介面裡安裝。主要功能是提供不少類型的正向和負向提示詞,另外也可以自動幫忙將提示詞翻譯成英文。對於英文詞彙沒那麼熟悉的話,會非常有幫助。
  • ControlNet - 可以直接從 webui 介面裡安裝。主要用來提昇對圖的控制,必裝,否則 Stable Diffusion 產生的圖太隨機了很難控制。

另外紀錄有討論到各種外掛以及提示詞的文章:

2023年10月23日 星期一

Vespa 的 parent document + weightedSet 撞牆筆記

簡要紀錄,最近遇到在 parent document 裡使用 weightedSet 做資料篩選的時候,本來還沒加 weightedSet 時,latency 是大約 25ms,加了 weightedSet 之後變成大約 730ms。

以下是當時的 schema 設定,簡要來說就是有個讓多個 child document 共用的欄位,叫做 sharedField,它被 child document 繼承時,欄位名字會叫做 fieldInParentDoc

# Schema in parent document.
field sharedField type weightedset<string> {
    indexing: attribute
    attribute: fast-search
}

# Schema in child document
field id type string {
    indexing: attribute
    attribute: fast-search
}

field parentReference type reference<parent_doc> {
    indexing: attribute
}

import field parentReference.sharedField as fieldInParentDoc {}

接著,在查詢時使用的 query 大約是這樣:

SELECT * FROM * sources WHERE (id contains "my_id_1" OR id contains "my_id_2") AND weightedSet(fieldInParentDoc, {"my_key":1});

實際上 ID 欄位是唯一值,並且 query 當中會有 5 個 ID,所以搜尋結果一定只會有 5 筆紀錄。理論上這應該會是很快的 query,但在加上後半段的 parent document 篩選條件後,速度就爆增了 28 倍。

不過如果幫這個 parent document 欄位設定 rank: filter,如下所示,讓它改成 bit vector 的形式,速度會變快不少。具體來說,專案裡測試的結果是會從 730ms 變成約 90ms。雖然還是很慢,但至少勉強還過得去…。

# Schema in parent document.
field sharedField type weightedset<string> {
    indexing: attribute
    attribute: fast-search
    rank: filter
}

2023年10月11日 星期三

在 Vespa 使用語義搜尋(一):簡要的基本知識

在搜尋的世界裡,語義搜尋(semantic search)是近代非常熱門的作法,它可以做到一些傳統的文字搜尋(text matching)做不到的事情。概念上來說,語義搜尋就是把句子的語義萃取出來,轉換成數學裡的向量來表達,然後再利用向量距離來衡量兩個句子的相關程度。這篇文章會簡要紀錄一點語義搜尋時,可能需要知道的基本知識。不過由於這裡面比較多跟資料科學比較有關的知識,在這方面我是個外行,所以這篇基本上都會比較以偏外行的視角在看待這些知識。

Vector Search

技術上來說,語義搜尋也可以稱之為 Vector Search,畢竟語義搜尋是透過向量來做搜尋。而要做語義搜尋,第一要務就是「要如何把一個字串轉換成向量」?這個轉換很大幅度決定了語義搜尋的結果,畢竟轉換成什麼樣的向量,就會決定它跟什麼東西比較近了。其中,把文字轉換成向量的行為,稱為詞嵌入(Embedding)。

Embedding 有很多種技術,近年來比較著名的演算法,就我所知大概是 BERT、FastText 等等的。具體來說,依據我們選擇的 embedding 演算法,會產生出不同維度的向量,這些向量放在向量空間中,就可以接著被用來計算點跟點的距離,並用以決定兩段文字是否相關。

Transformer

Transformer 是 Google 在 2017 年發表的神經網路架構,就我的理解是,這個架構最大的不同是讓神經網路的計算能夠平行化,使得大型模型的訓練變成了可能。目前比較常聽到的像是 GPT(Generative Pre-trained Transformers)、BERT(Bidirectional Encoder Representations from Transformers) 等模型,都是基於 Transformer 架構開發出來的。

Hugging Face

由於市場上現在有很多種模型架構和應用環境,例如有些模型用 TensorFlow、有些用 PyTorch 等等。Hugging Face 是用來提供統一的 API 介面,使得不同架構的模型能夠互通。細節可以參考文章

ONNX

ONNX(Open Neural Network Exchange)是一種神經網路的資料交換格式,用來讓不同架構(例如 Google 的 Tensorflow、Meta 的 PyTorch、微軟的 CNTX 等)訓練出來的模型能夠互通在其他架構。不過據說 Tensorflow 因為發展較早,已經有自己成熟的環境,因此並不支援 ONNX,但有工具能夠將 Tensorflow 模型轉換成 ONNX 格式,如 tf2onnx

Nearest Neighbor Search

NN(Nearest Neighbor)是在向量空間中尋找最近的點的問題。比較著名的解法是 KNN(K-nearest neighbor algorithm)。

Approximate Nearest Neighbor Search

ANN(Approximate Nearest Neighbor Search)是改良版的 NN,目標是用比較粗略的方式,在向量空間中找出距離最近的點。Vespa 在使用 ANN 去計算尋找最近的點時,使用的演算法是 HNSW。

2023年9月14日 星期四

系統碟備份的經驗紀錄

這兩天因為換系統碟,把古老的 Intel 240GB 換成美光 MX500 1TB,所以遇到一些奇怪的問題。簡單做個筆記。

首先是系統碟備份的部份,我是直接用 Macrium Reflect v8.0.6758。本來要下載安裝檔,正要安裝時發現原來電腦裡本來就有裝了,於是就直接用裝好的版本。不過新版的疑似沒有個人使用的免費版了?用這個直接在 Windows 裡就能夠對系統碟做 clone disk 了,還蠻方便的。

磁碟轉移完成後,我又做了一件事是把一顆快壞掉的硬碟拔掉,之前把那顆硬碟設成虛擬磁碟和暫存資料區,現在就直接不用它了。不過我完全忘了自己做了什麼設定,所以後來遇到奇奇怪怪的問題,其實都跟它有關。

首先遇到的問題,是 Line 沒辦法打開圖片,把 Line 重裝以後甚至變成連打開圖片需要的套件都裝不了,下載完後會顯示無法安裝。接著遇到我想刪掉 Line 重裝,結果用 Firefox 要下載時,發現 Firefox 無法下載檔案了,所有連結點了都是立刻失敗(但用 Firefox 以外的瀏覽器就可以下載)。接著我想找系統清理的軟體,嘗試想清理看看什麼登錄檔之類的,然後發現微軟也有出相關的軟體,就去下載微軟的安裝檔,結果安裝檔下載下來雙擊安裝時也失敗,無法安裝。最後是在 Edge 上下載某個檔案並從 Edge 點擊安裝時,才終於彈出一個錯誤訊息說「找不到 T:\」.....。這時我才終於注意到,原來這一系列奇奇怪怪的問題,都是因為某種暫存檔的設定,是設定在被我拔掉的那顆硬碟磁區上.....。於是去改了環境變數的 TEMP 和 TMP 路徑,換成另一顆硬碟,一切就恢復正常了。

OS:過程中我刪掉了 Line 和 Firefox,害我好多東西要重新設定....。但還好 Firefox ESR 移除重裝,它還找得到原本的百來個分頁,算是一個小雀幸了....。

除了 TEMP 造成的問題以外,還有另一個有點沒頭緒的問題是,換成新硬碟後,PPPoE 就再也連不上了。費了一番功夫(主要是依靠 ChatGPT 跟 Google)後,發現修復的方法似乎是先移除 PPPoE 設定,然後去裝置管理員,把所有「網路介面卡」底下的 WAN Miniport 全部移除,然後讓它重新掃描一次硬體變更,自動裝回那些 WAN Miniport 後,再重設一次 PPPoE,就可以修復了。也可以參考微軟的說明

2023年8月31日 星期四

[書籤] GC Log Analyzer

Azul 有提供免費的 GC log analyzer 可以用來把 gc log 圖形化。

https://docs.azul.com/prime/GC-Log-Analyzer

2023年8月15日 星期二

MapStruct 不支援 lombok fluent accessors

快速筆記,MapStruct 沒有要支援 lombok 的 fluent accessors,因為這樣他們會掃出所有的 method 而無法正確判斷哪個 method 才是 getter/setter。

可以參考 Github issue:https://github.com/mapstruct/mapstruct/issues/3286

2023年4月26日 星期三

基本的 OpenTelemetry Metrics 設定:讓 Counter 只紀錄差異

上一篇文章中,我用 LongCounter 來計算收到的 event 數量,並且讓 OTEL 每一秒輸出一次資料到 log 裡。不過其實這個作法跟我本來想像的結果不太相同,因為我想像的是例如第一秒收到 5 個 event、第二秒收到 7 個 event,OTEL 輸出的 Metrics 應該要是:

  • 第一個 data point 是 5
  • 第二個 data point 是 7
  • 第三個 data point 是 0

但事實上當時寫出來的範例程式會輸出的結果會是:

  • 第一個 data point 是 5
  • 第二個 data point 是 12
  • 第三個 data point 是 12

也就是說,範例程式紀錄下來的是累計值,是從 application 啟動開始累計到現在的所有數值的加總。但我希望紀錄下來的其實是差異值,每次 Exporter 輸出完 Metrics 後,我希望它重置 counter。

設定 Exporter 輸出差異值

要達成紀錄的是差異值,要做的事情是去設定 Exporter 的 AggregationTemporality。具體設定的方法其實每個 Exporter 都有點不一樣,不過都是在 ...Builder 的階段控制的。這裡繼續以 LoggingMetricExporter 為例,LoggingMetricExporter 設定 temporality 的方法如下:

LoggingMetricExporter.create(AggregationTemporality.DELTA);

測試方法

設定了 AggregationTemporality 之後,把測試的腳本稍微弄複雜一點,大體來說就是改成用 2 個 thread 模擬送出 1M 個 event,然後觀察 OTEL 紀錄到什麼東西。為了簡化測試,我把一些本來隨機的東西都拿掉,會比較方便觀察數字的正確性 XD。

@Override
public void run(String... args) throws Exception {
    log.info("Run");

    produceEvents(1_000_000, 10);

    log.info("Done");
}

private void produceEvents(int numOfEvents, int numOfThreads) {
    var executor = Executors.newFixedThreadPool(numOfThreads);

    for (int i = 0; i < numOfEvents; i++) {
        executor.submit(() -> {
            if (random.nextBoolean()) {
                processor1.receiveEvent(generateRandomEvent());
            } else {
                processor2.receiveEvent(generateRandomEvent());
            }
        });
    }
}

private Event generateRandomEvent() {
    var eventType = "create";

    return Event.builder()
            .eventType(eventType)
            .owner("owner-1")
            .build();
}

完整的範例程式可以參考這裡

執行結果

以下是執行時,OTEL 輸出的結果。

INFO  i.o.e.l.LoggingMetricExporter [PeriodicMetricReader-1] Received a collection of 1 metrics for export.
INFO  i.o.e.l.LoggingMetricExporter [PeriodicMetricReader-1] metric: ImmutableMetricData{resource=Resource{schemaUrl=null, attributes={service.name="otel-example", telemetry.sdk.language="java", telemetry.sdk.name="opentelemetry", telemetry.sdk.version="1.22.0"}}, instrumentationScopeInfo=InstrumentationScopeInfo{name=event-consumer, version=1.0.0, schemaUrl=null, attributes={}}, name=eventType, description=Metrics for the event consuming., unit=1, type=LONG_SUM, data=ImmutableSumData{points=[ImmutableLongPointData{startEpochNanos=1682522136538247300, epochNanos=1682522137553247500, attributes={eventType="create", owner="owner-1"}, value=584412, exemplars=[]}], monotonic=true, aggregationTemporality=DELTA}}
INFO  i.o.e.l.LoggingMetricExporter [PeriodicMetricReader-1] Received a collection of 1 metrics for export.
INFO  i.o.e.l.LoggingMetricExporter [PeriodicMetricReader-1] metric: ImmutableMetricData{resource=Resource{schemaUrl=null, attributes={service.name="otel-example", telemetry.sdk.language="java", telemetry.sdk.name="opentelemetry", telemetry.sdk.version="1.22.0"}}, instrumentationScopeInfo=InstrumentationScopeInfo{name=event-consumer, version=1.0.0, schemaUrl=null, attributes={}}, name=eventType, description=Metrics for the event consuming., unit=1, type=LONG_SUM, data=ImmutableSumData{points=[ImmutableLongPointData{startEpochNanos=1682522137553247500, epochNanos=1682522138548844500, attributes={eventType="create", owner="owner-1"}, value=415588, exemplars=[]}], monotonic=true, aggregationTemporality=DELTA}}
DEBUG i.o.s.m.e.PeriodicMetricReader [PeriodicMetricReader-1] No metric data to export - skipping export.

文字太長了,稍微摘要一下:

....attributes={eventType="create", owner="owner-1"}, value=584412, exemplars=[]....
....attributes={eventType="create", owner="owner-1"}, value=415588, exemplars=[]....
....No metric data to export - skipping export.

可以看到它第一秒紀錄到的 count 是 584,412、第二秒紀錄到的是 415,588,兩秒合計就是 1M,正好是我的測試程式送出的數目。兩秒過去後,因為後續沒有再呼叫 method,所以 OTEL 沒有繼續收到新的 metric data,就會看到 skipping export 的訊息。